Forest 500 (Global Canopy), 2026
Repenser l’évaluation de 500 entreprises sur la déforestation
Seule designer sur la refonte de la plateforme d’évaluation de Forest 500, qui réunit la saisie des données, la revue qualité et les commentaires des entreprises dans un espace de travail pour les chercheurs et un portail pour les entreprises.
Aperçu
Une seule plateforme pour évaluer 500 entreprises chaque année
Forest 500 est un projet de Global Canopy qui identifie les 500 entreprises les plus exposées au risque de déforestation, et les évalue chaque année sur leurs politiques et leurs actions pour neuf matières premières, de l’huile de palme et du soja au bœuf, au cacao et au bois. Chaque score repose sur des informations publiques.
Derrière chaque cycle annuel, il y a beaucoup de travail : les chercheurs renseignent chaque indicateur pour chaque entreprise, des relecteurs vérifient la notation, et les entreprises peuvent commenter leur évaluation. J’étais la seule designer sur la refonte de la plateforme qui rend tout cela possible, en remplaçant un outil historique par un espace de travail pour les chercheurs et un portail pour les entreprises.
L’impact
Tout le cycle de vie d’une évaluation se trouve désormais au même endroit, et les nouveaux parcours ont été validés avec des prototypes Lovable construits sur les vraies données des indicateurs avant le début du développement.
Problème
Un outil historique qui compliquait chaque étape
Au fil des années, l’outil existant était devenu un ensemble de pages séparées : listes d’entreprises, nettoyage des données et même requêtes brutes sur la base de données, chacune avec ses propres filtres et peu d’aide. Les chercheurs devaient savoir où tout se trouvait, et l’outil ne donnait aucune vue d’ensemble de l’avancement, de ce qui devait être relu, ni de qui travaillait sur quoi.
Côté entreprises, mêmes problèmes. Les entreprises ont fait savoir à Global Canopy que commenter leur évaluation demandait beaucoup d’efforts : les brouillons pouvaient se perdre, il était impossible d’exporter l’évaluation pour la partager en interne, et plusieurs collègues ne pouvaient pas y travailler ensemble.
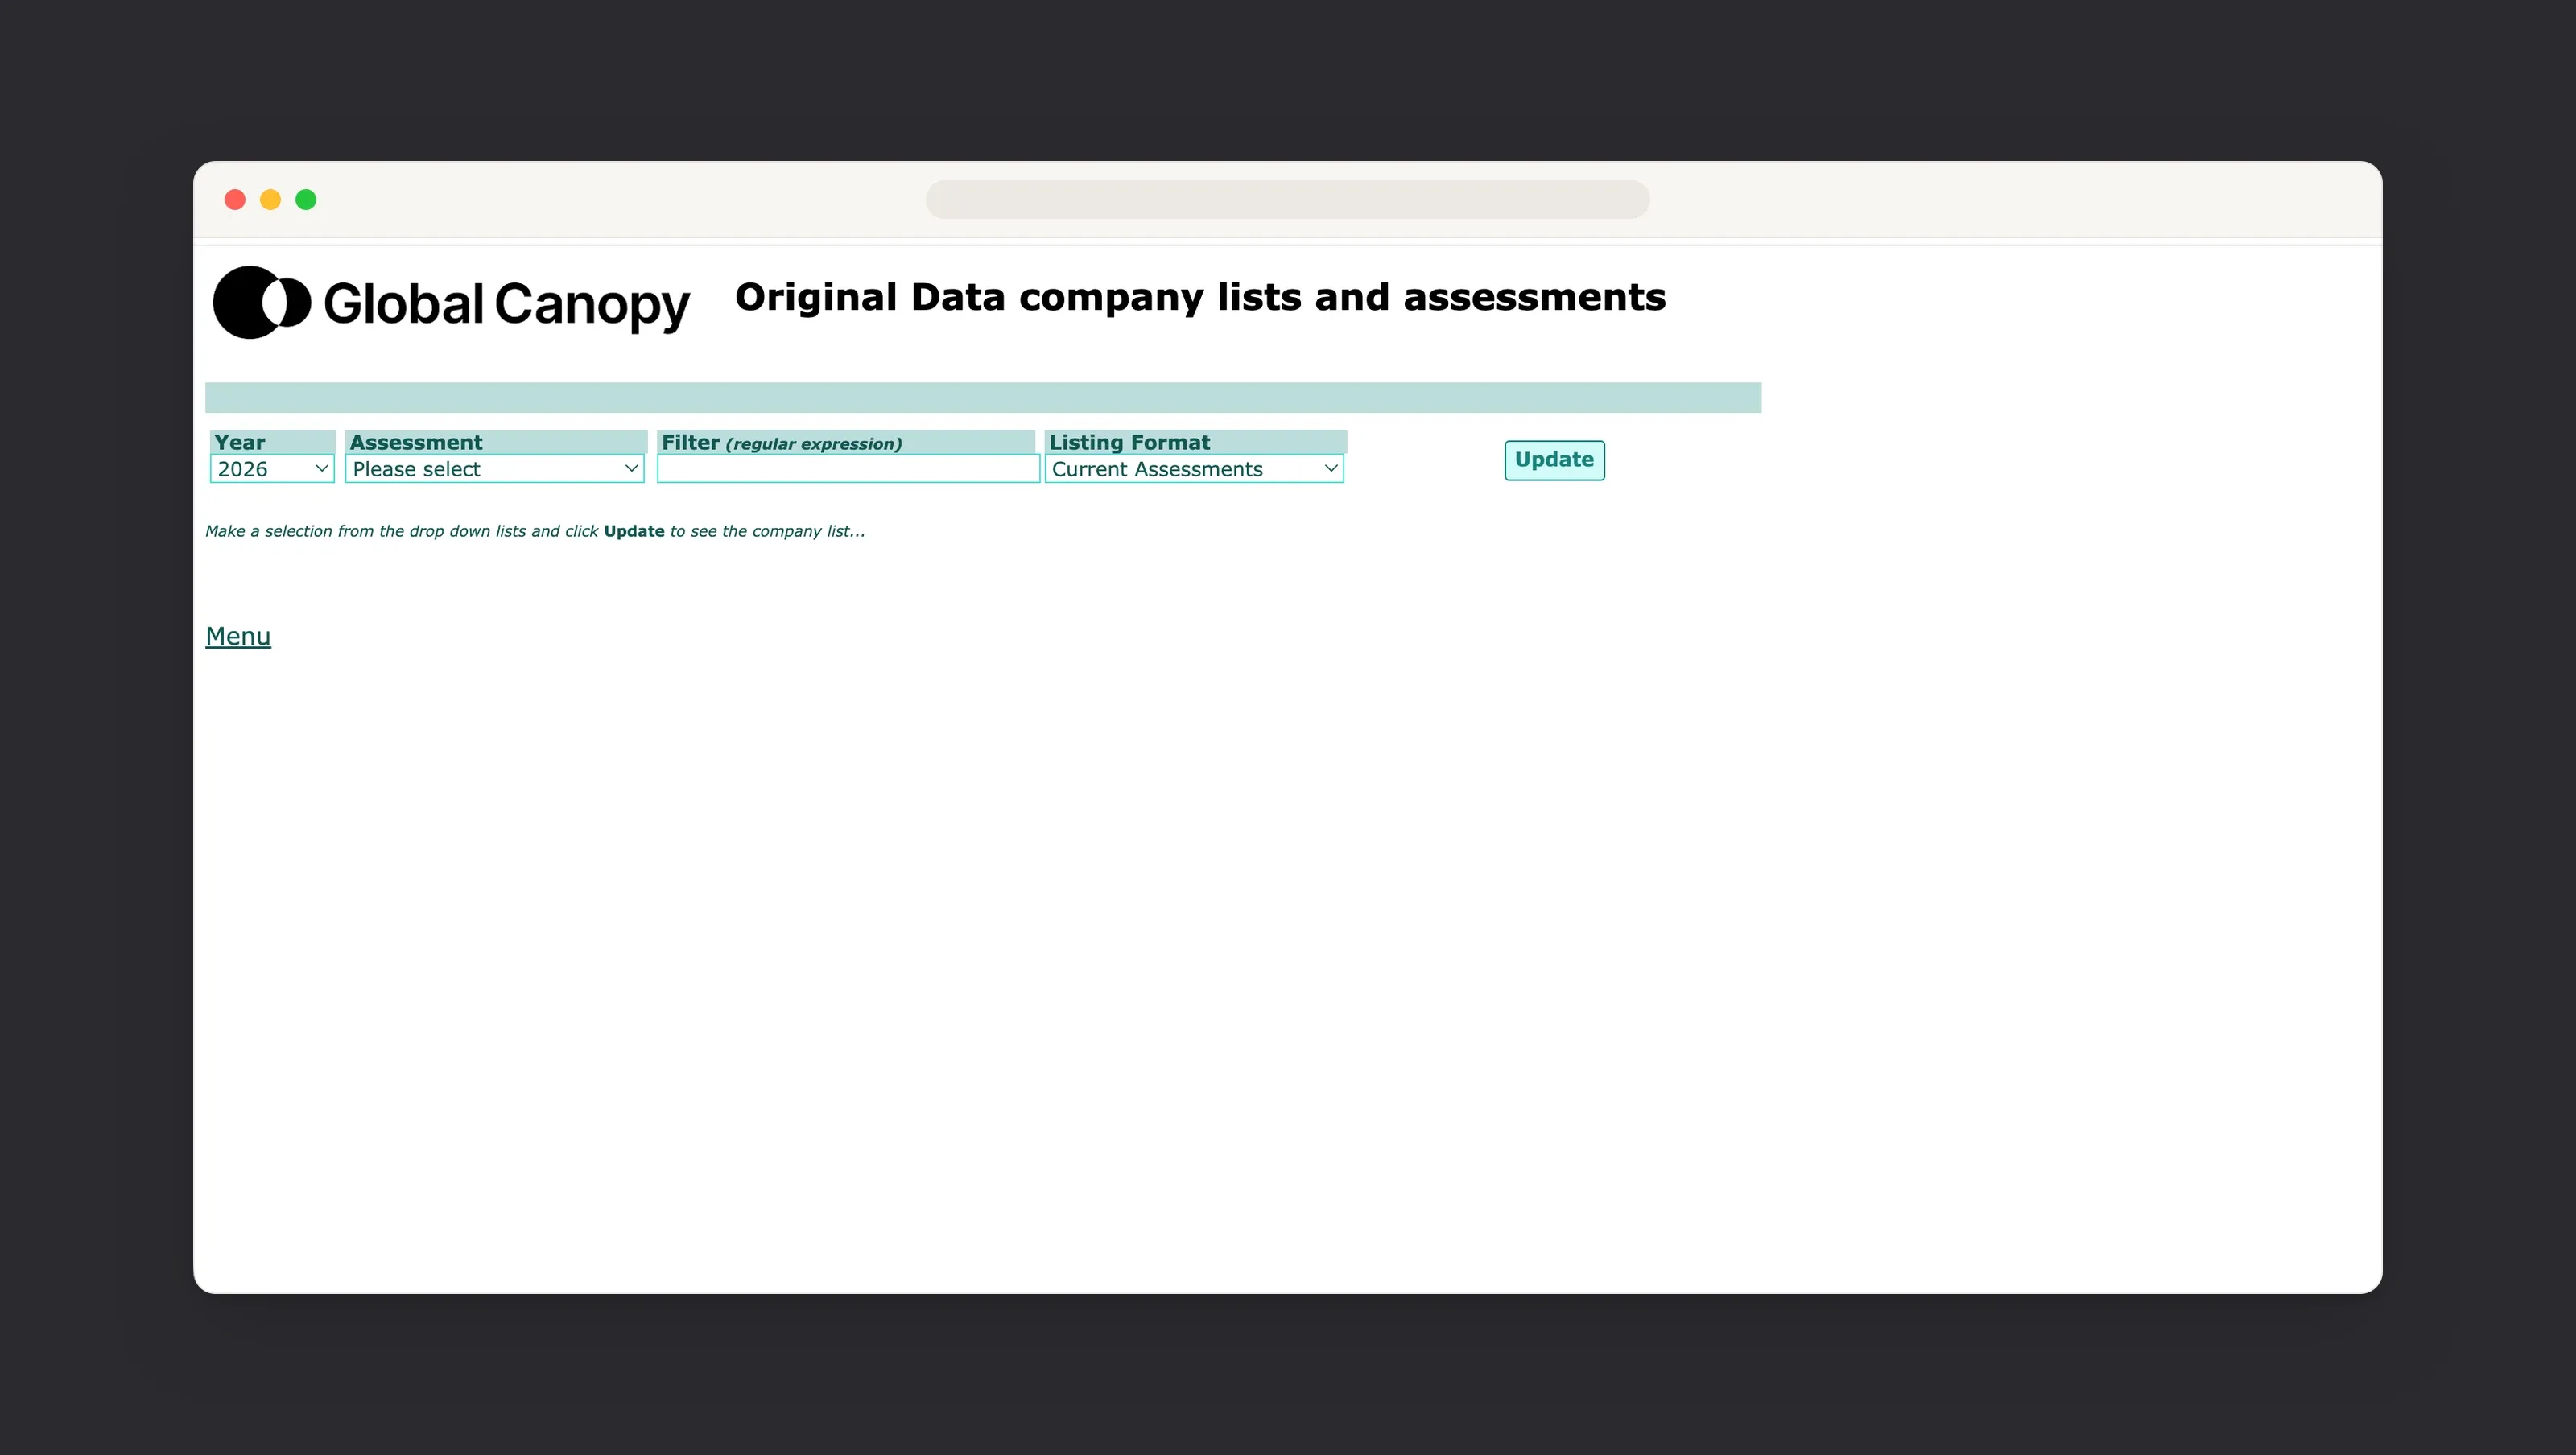
Aucune vue d’ensemble
Aucune vue unique de l’avancement des évaluations, de ce qui devait être relu, ni de qui travaillait sur quoi.Des étapes éparpillées
La saisie, les contrôles qualité et les commentaires des entreprises se faisaient à des endroits différents, avec des règles différentes.Pénible pour les entreprises
Brouillons perdus, pas d’export et aucun moyen de collaborer : la période de commentaires devenait une corvée.
Recherche
Cartographier tout le cycle de vie d’une évaluation
J’ai commencé par auditer l’outil historique et cartographier chaque étape par laquelle passe une évaluation, ainsi que chaque rôle impliqué : chercheurs et assistants de recherche, relecteurs, administrateurs et les entreprises elles-mêmes.
Cette carte est devenue la colonne vertébrale de la plateforme. Une évaluation passe de la saisie des données aux contrôles automatiques, puis à l’assurance qualité. Elle est ensuite soit renvoyée au chercheur avec des notes, soit approuvée et verrouillée pour la période de commentaires des entreprises.
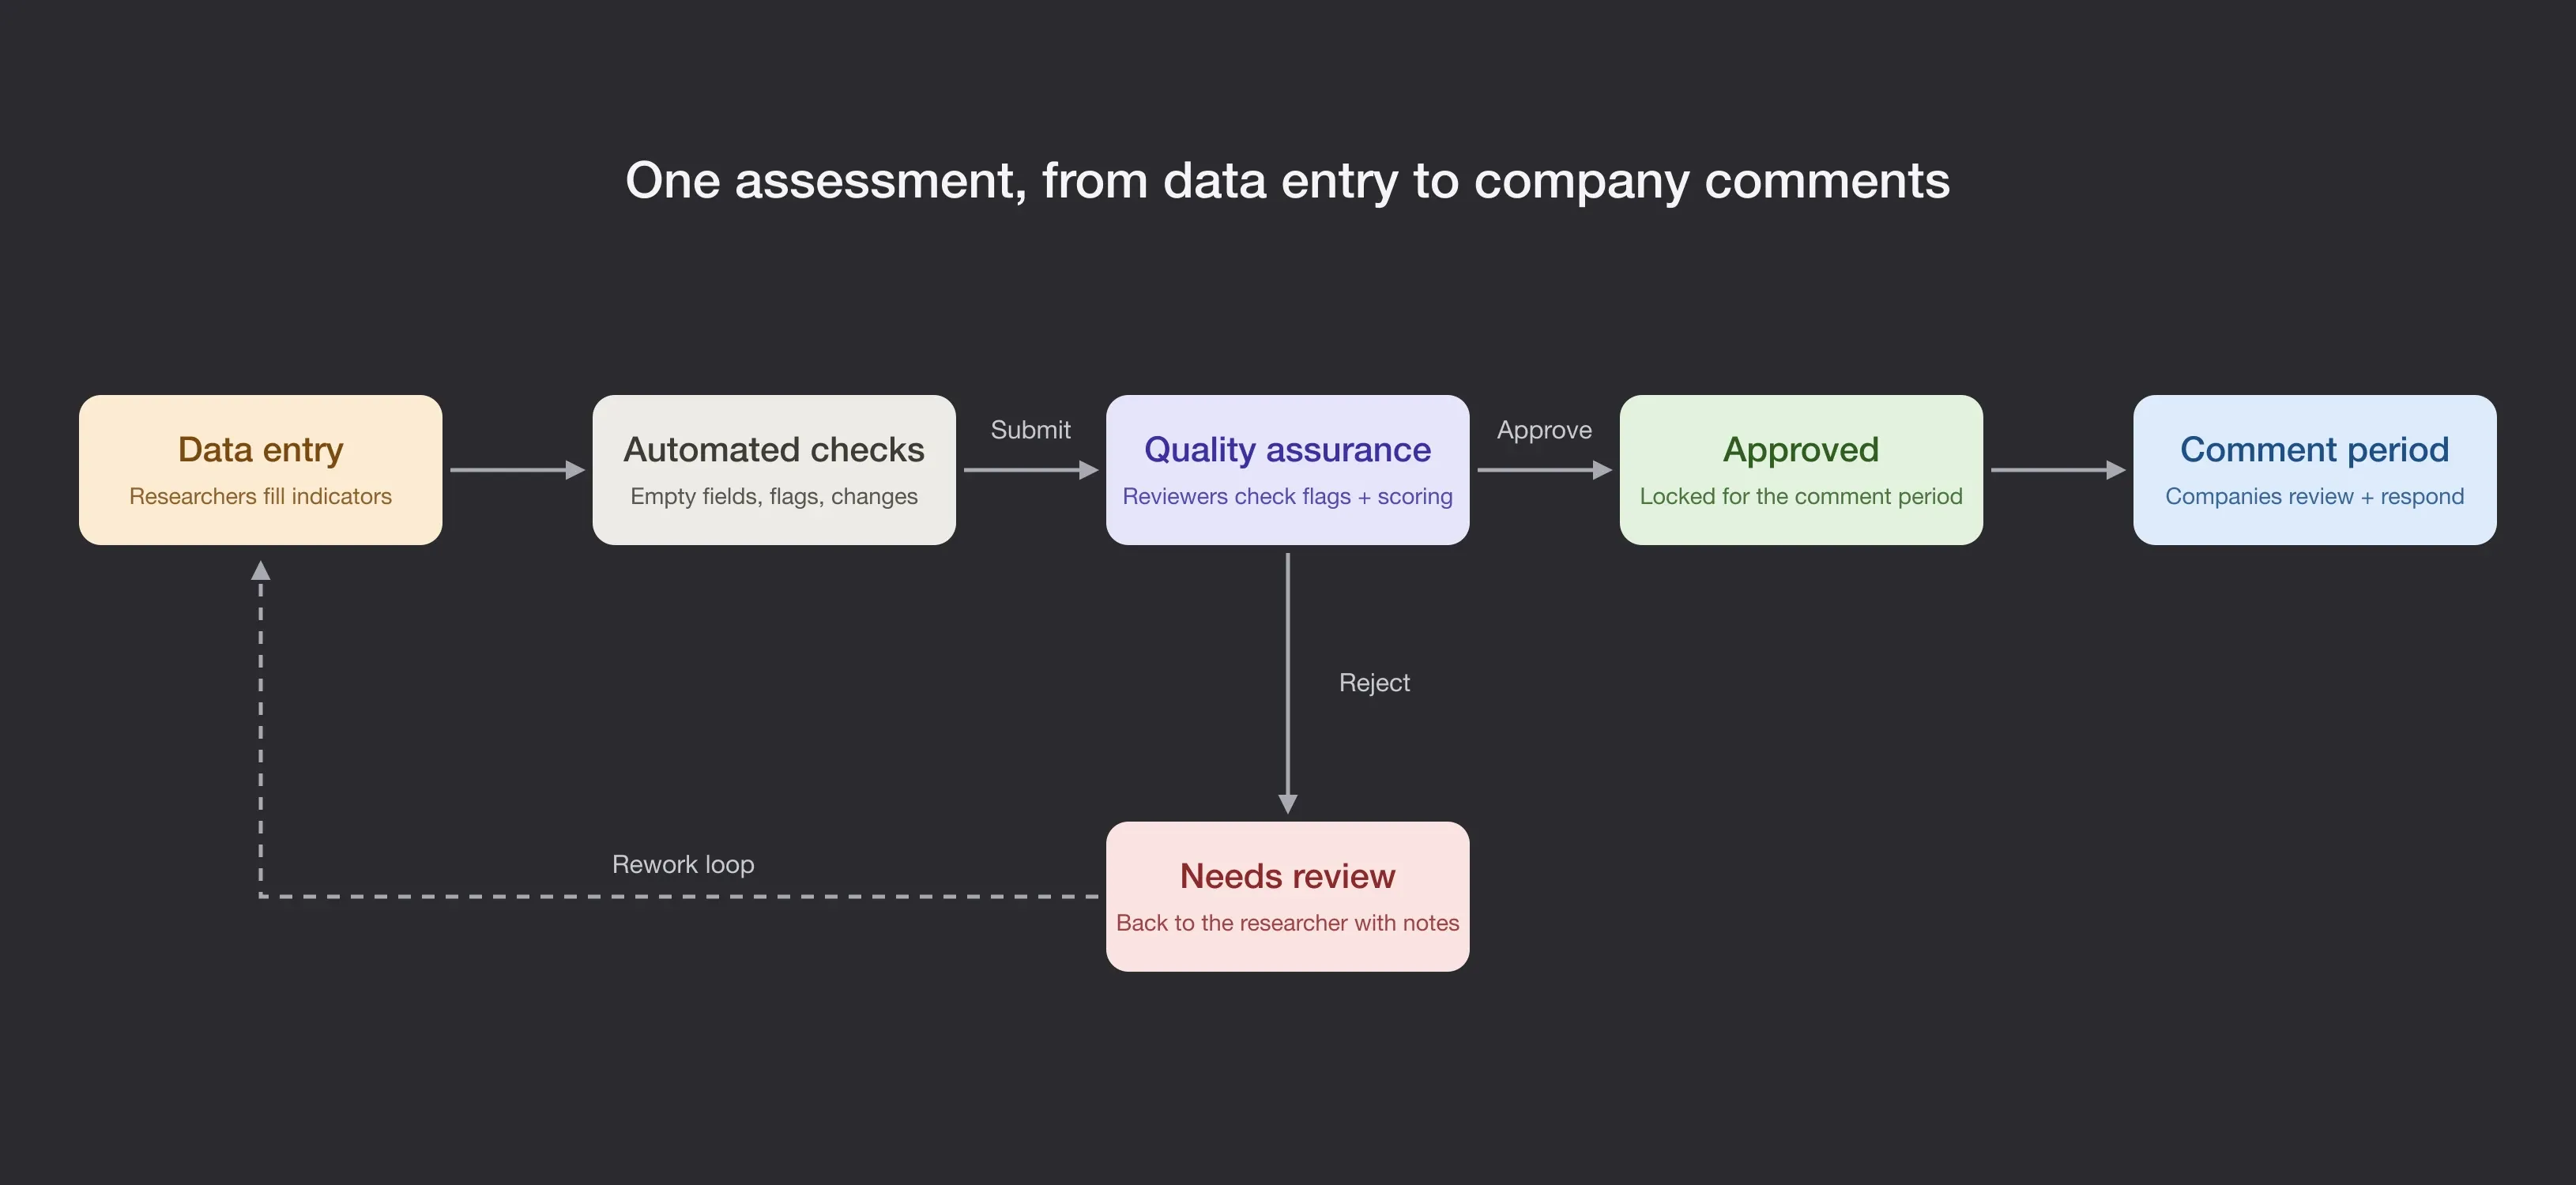
Cartographier le processus de cette façon a fait émerger les questions qui ont façonné le design : qui fait passer une évaluation en revue, si cela se fait par entreprise ou par section, et à quel point la plateforme doit distinguer les évaluations d’entreprises de celles d’institutions financières, qui suivent des méthodologies différentes.
Idéation
Prototyper sur les vraies données des indicateurs
J’ai séparé la plateforme en deux : un espace de travail pour l’équipe de recherche, et un portail où les entreprises consultent leur évaluation et y répondent.
Plutôt que de tester avec du contenu fictif, j’ai construit des prototypes Lovable sur les vraies questions des indicateurs et leurs options de réponse. L’équipe de recherche pouvait parcourir une évaluation complète telle qu’elle apparaîtrait réellement, ce qui a rendu les retours bien plus concrets et nous a permis de trancher tôt les questions de structure et de formulation.
Designs
Un espace de travail pour les chercheurs et un portail pour les entreprises
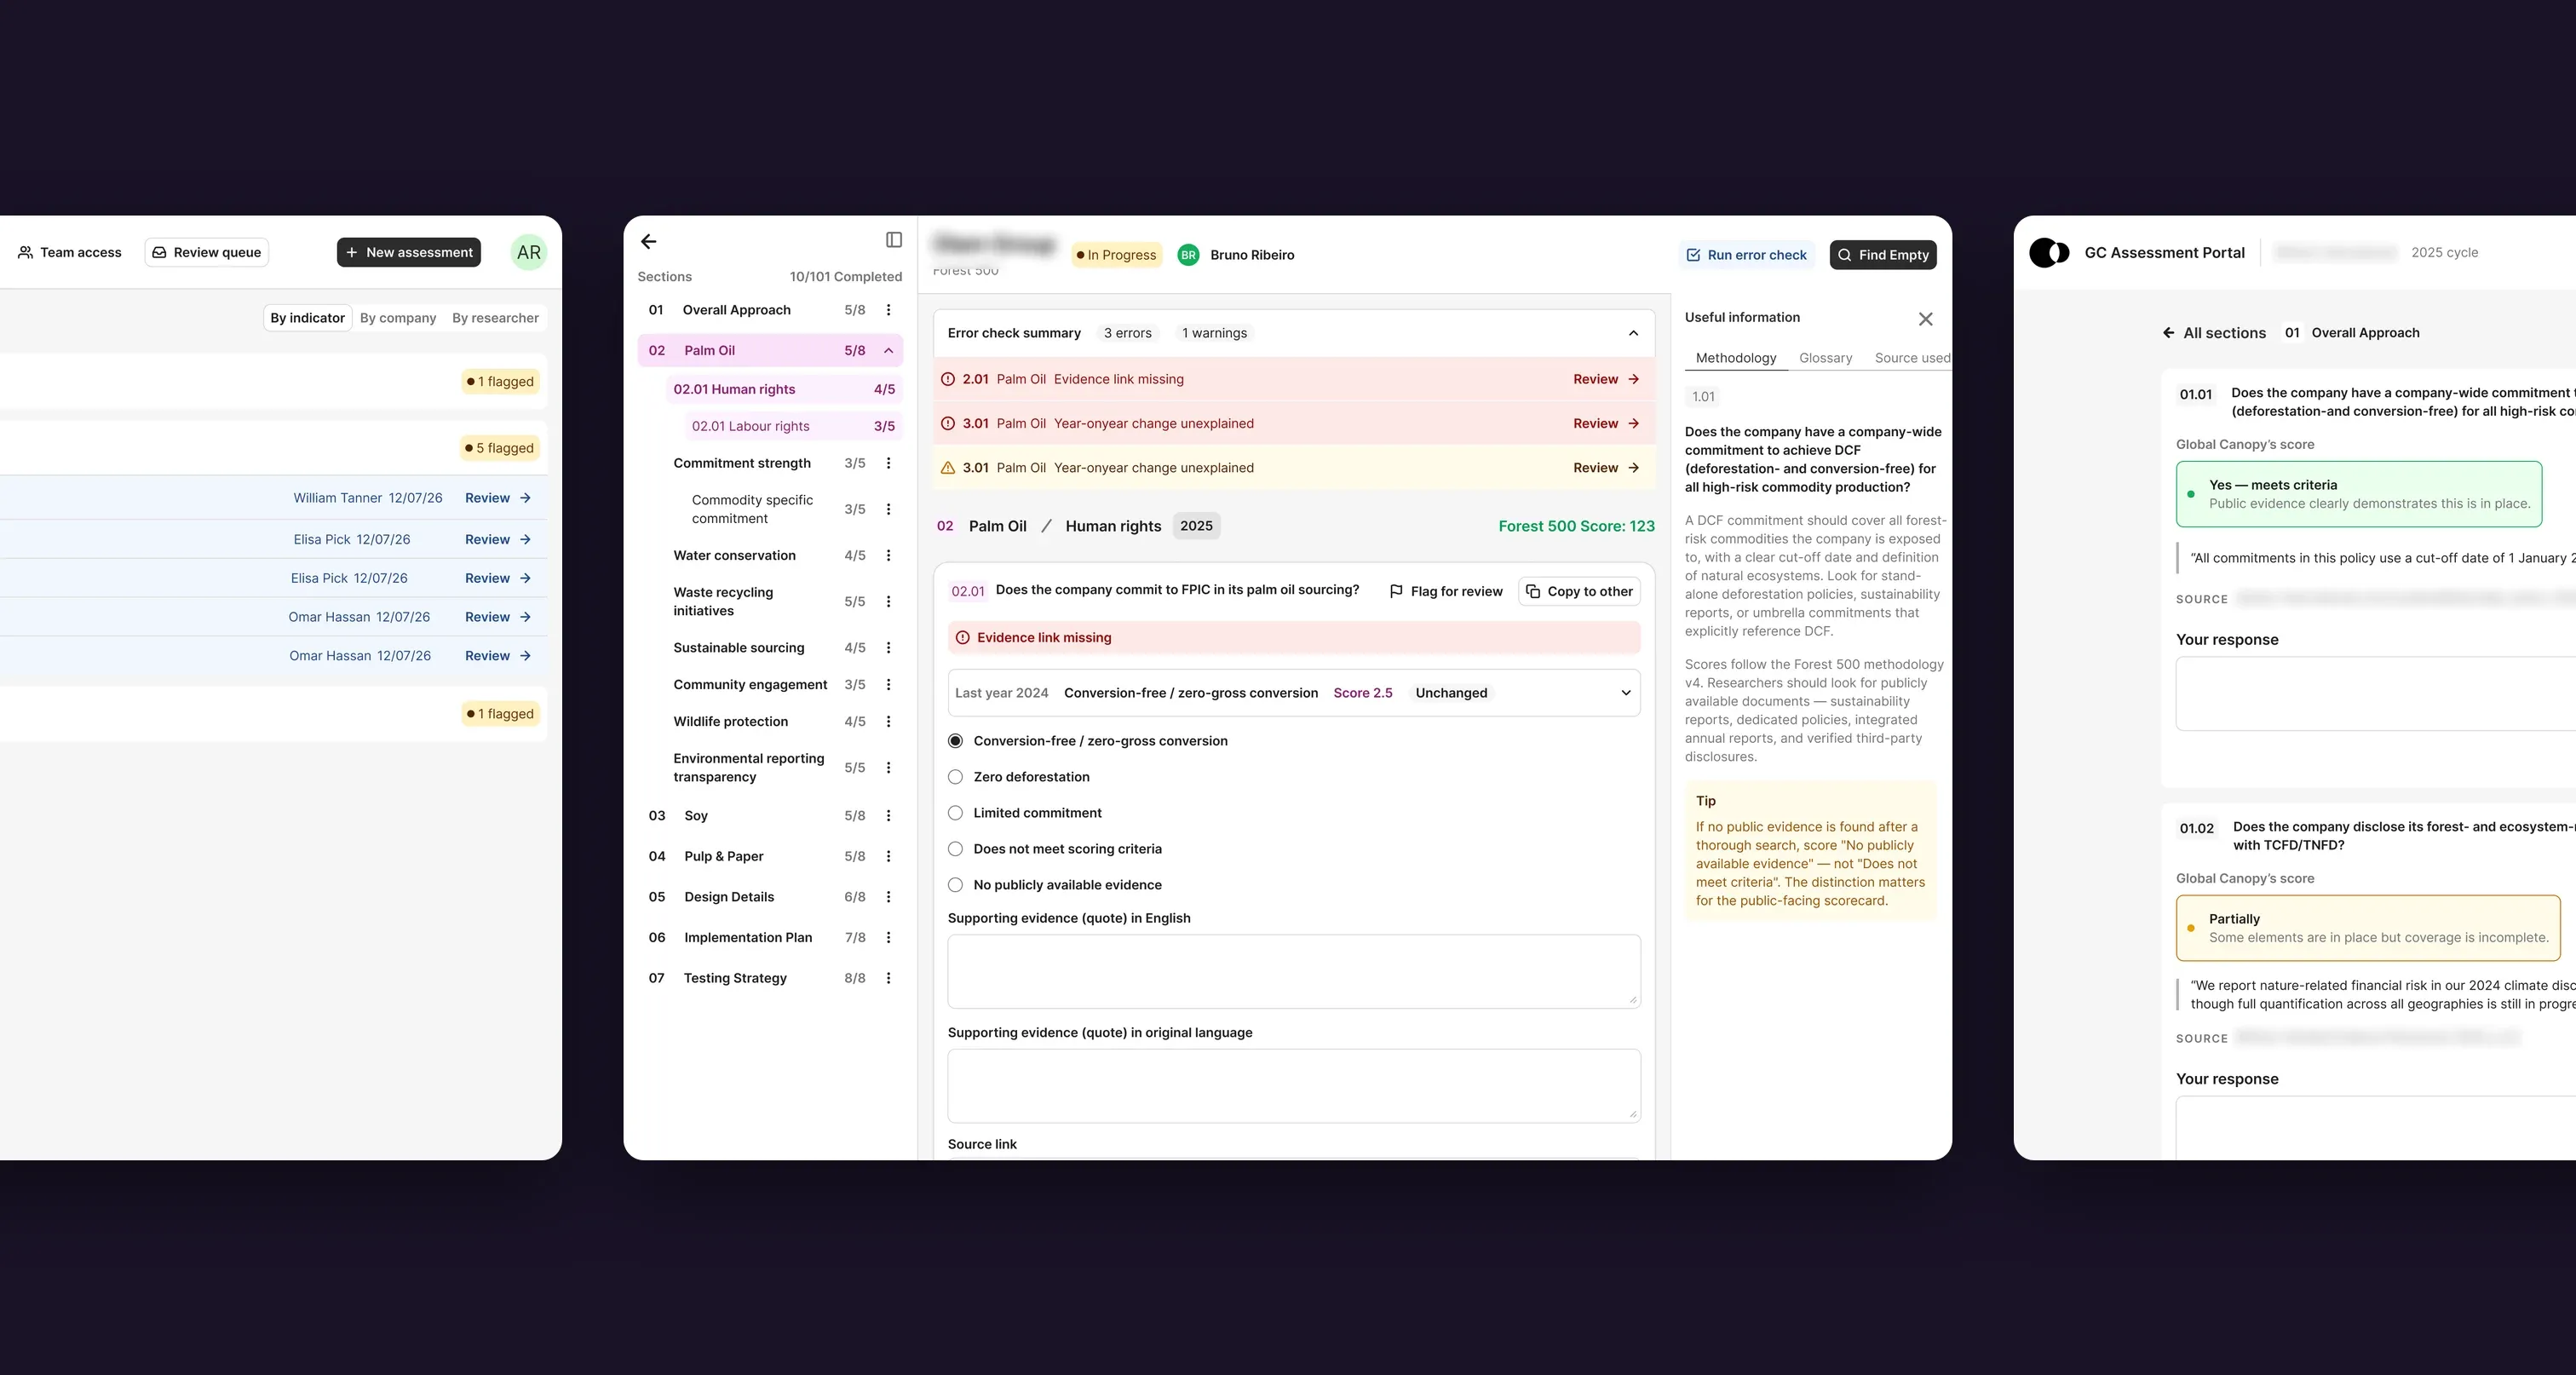
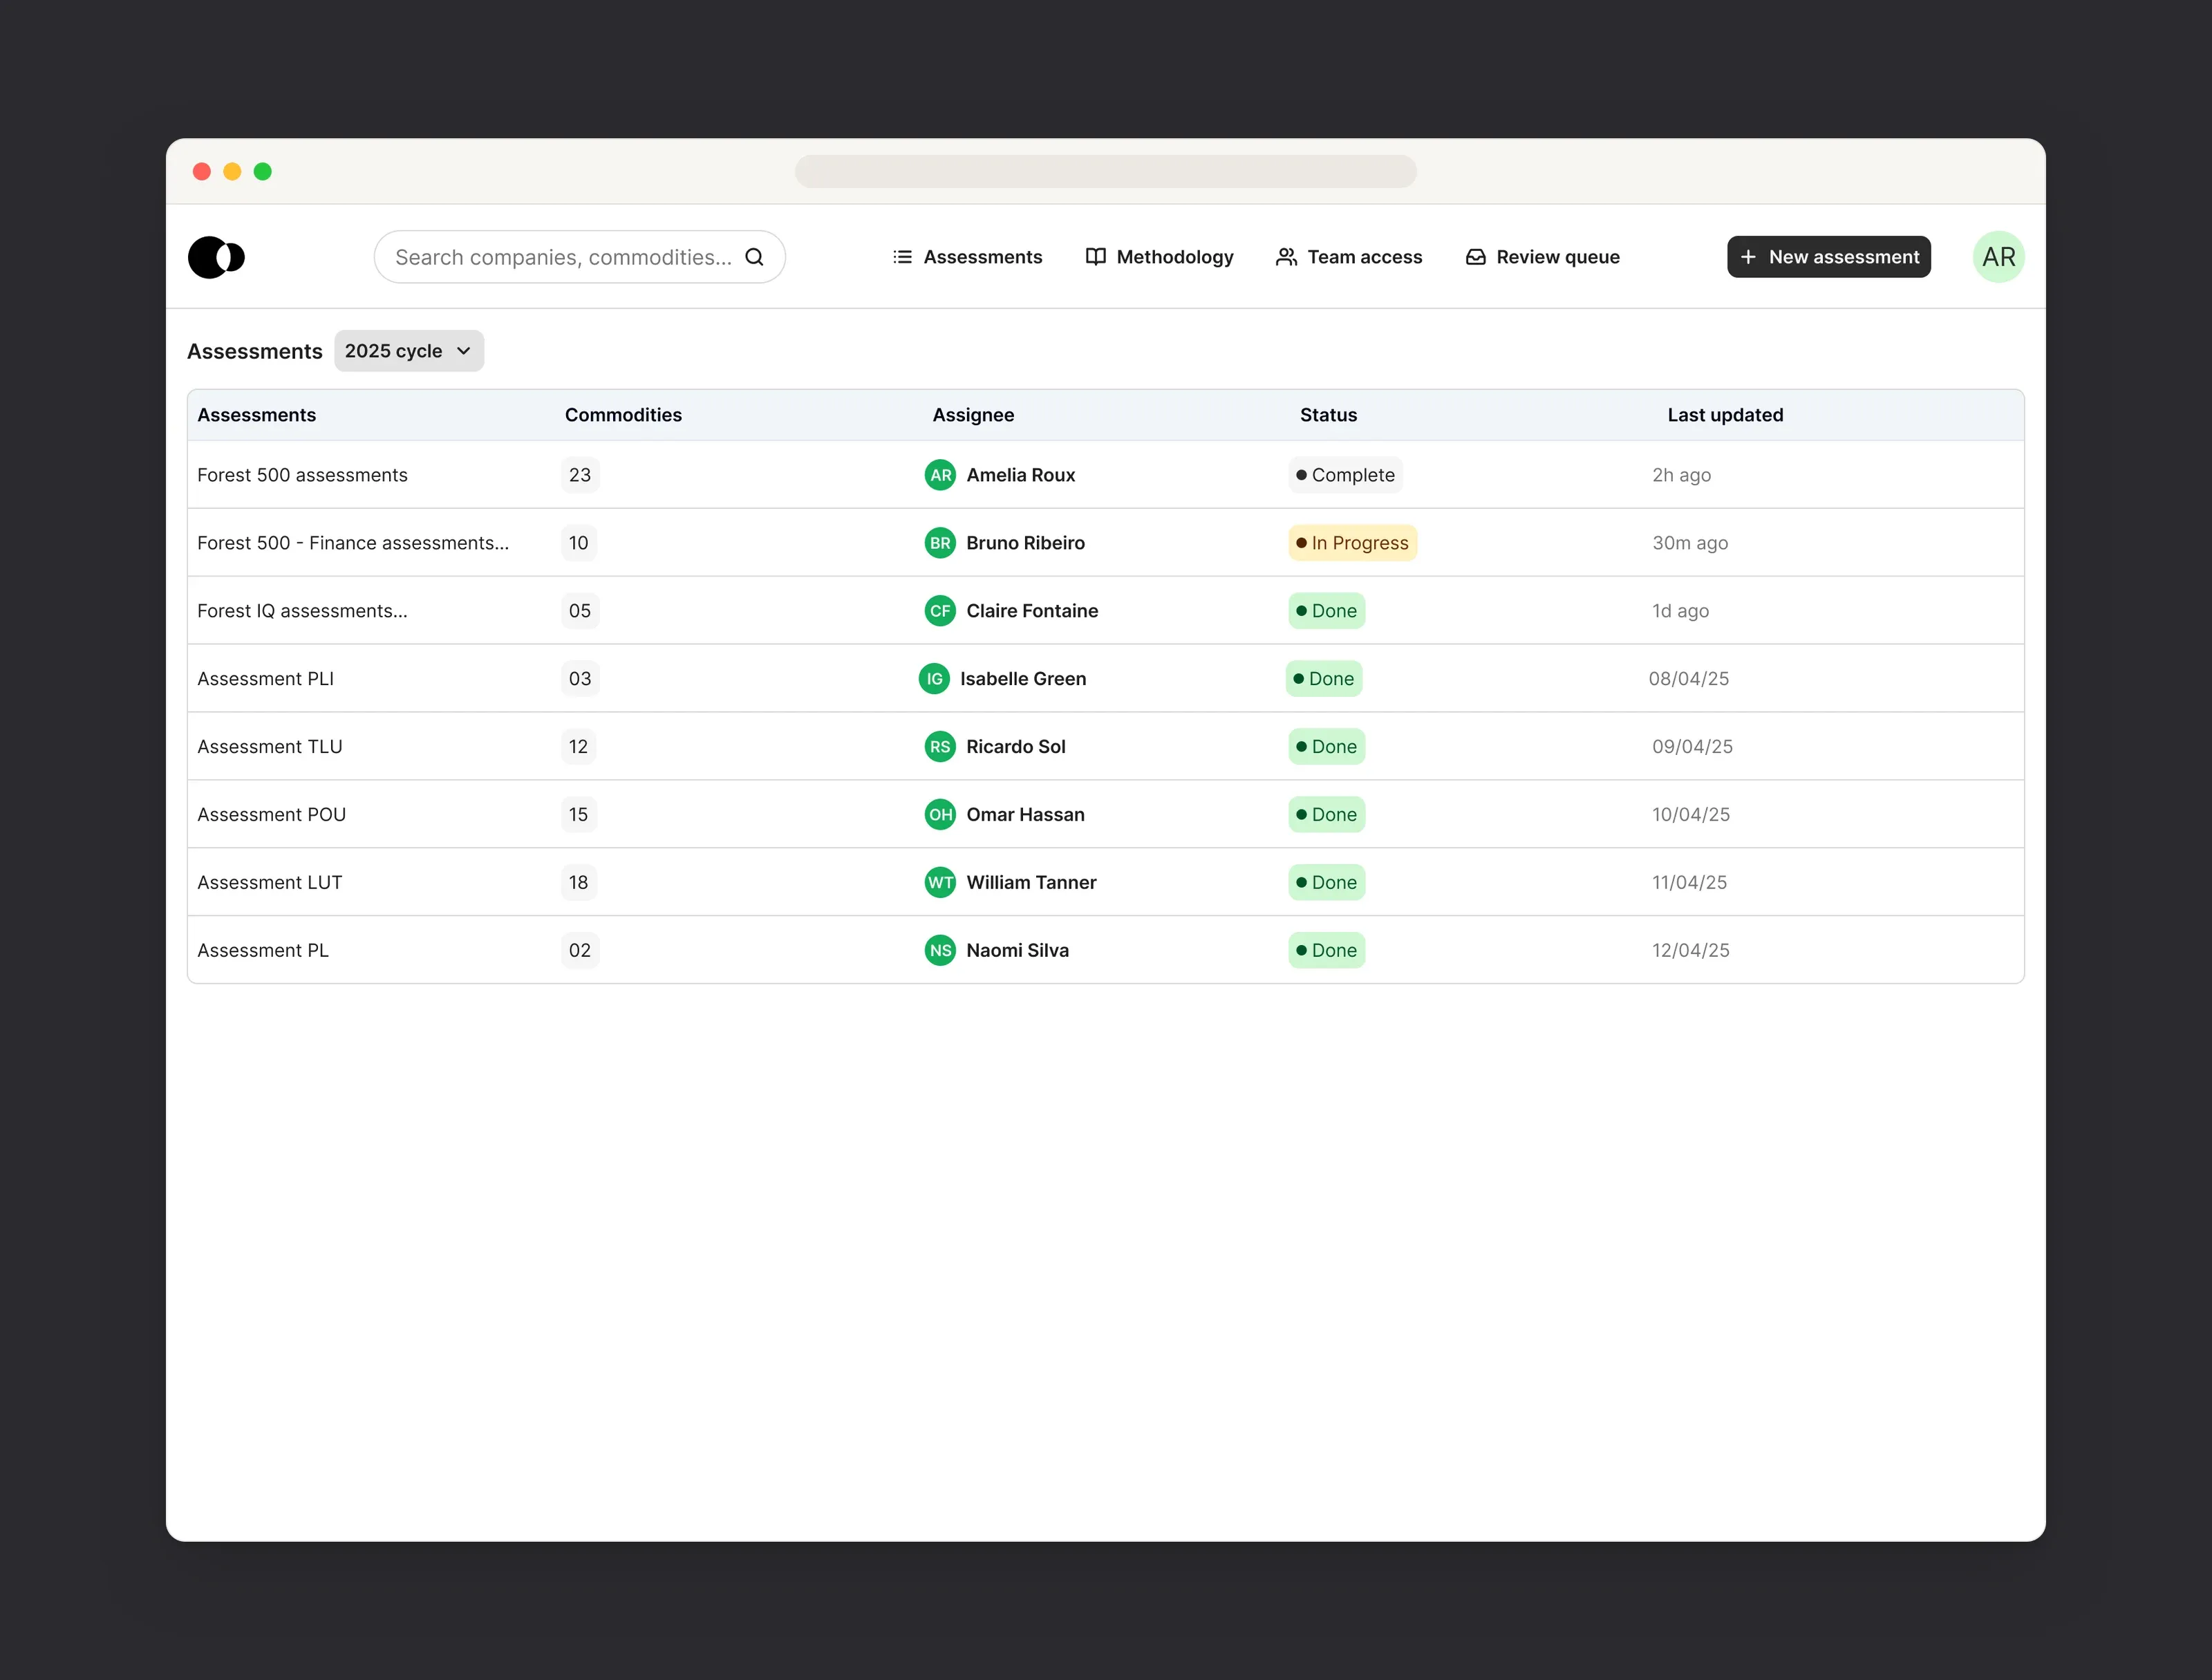
Les évaluations en un coup d’œil
Les chercheurs partent d’une liste de toutes les évaluations du cycle, avec leur responsable, leur statut et leur dernière mise à jour, pour que l’équipe sache toujours où en sont les choses.
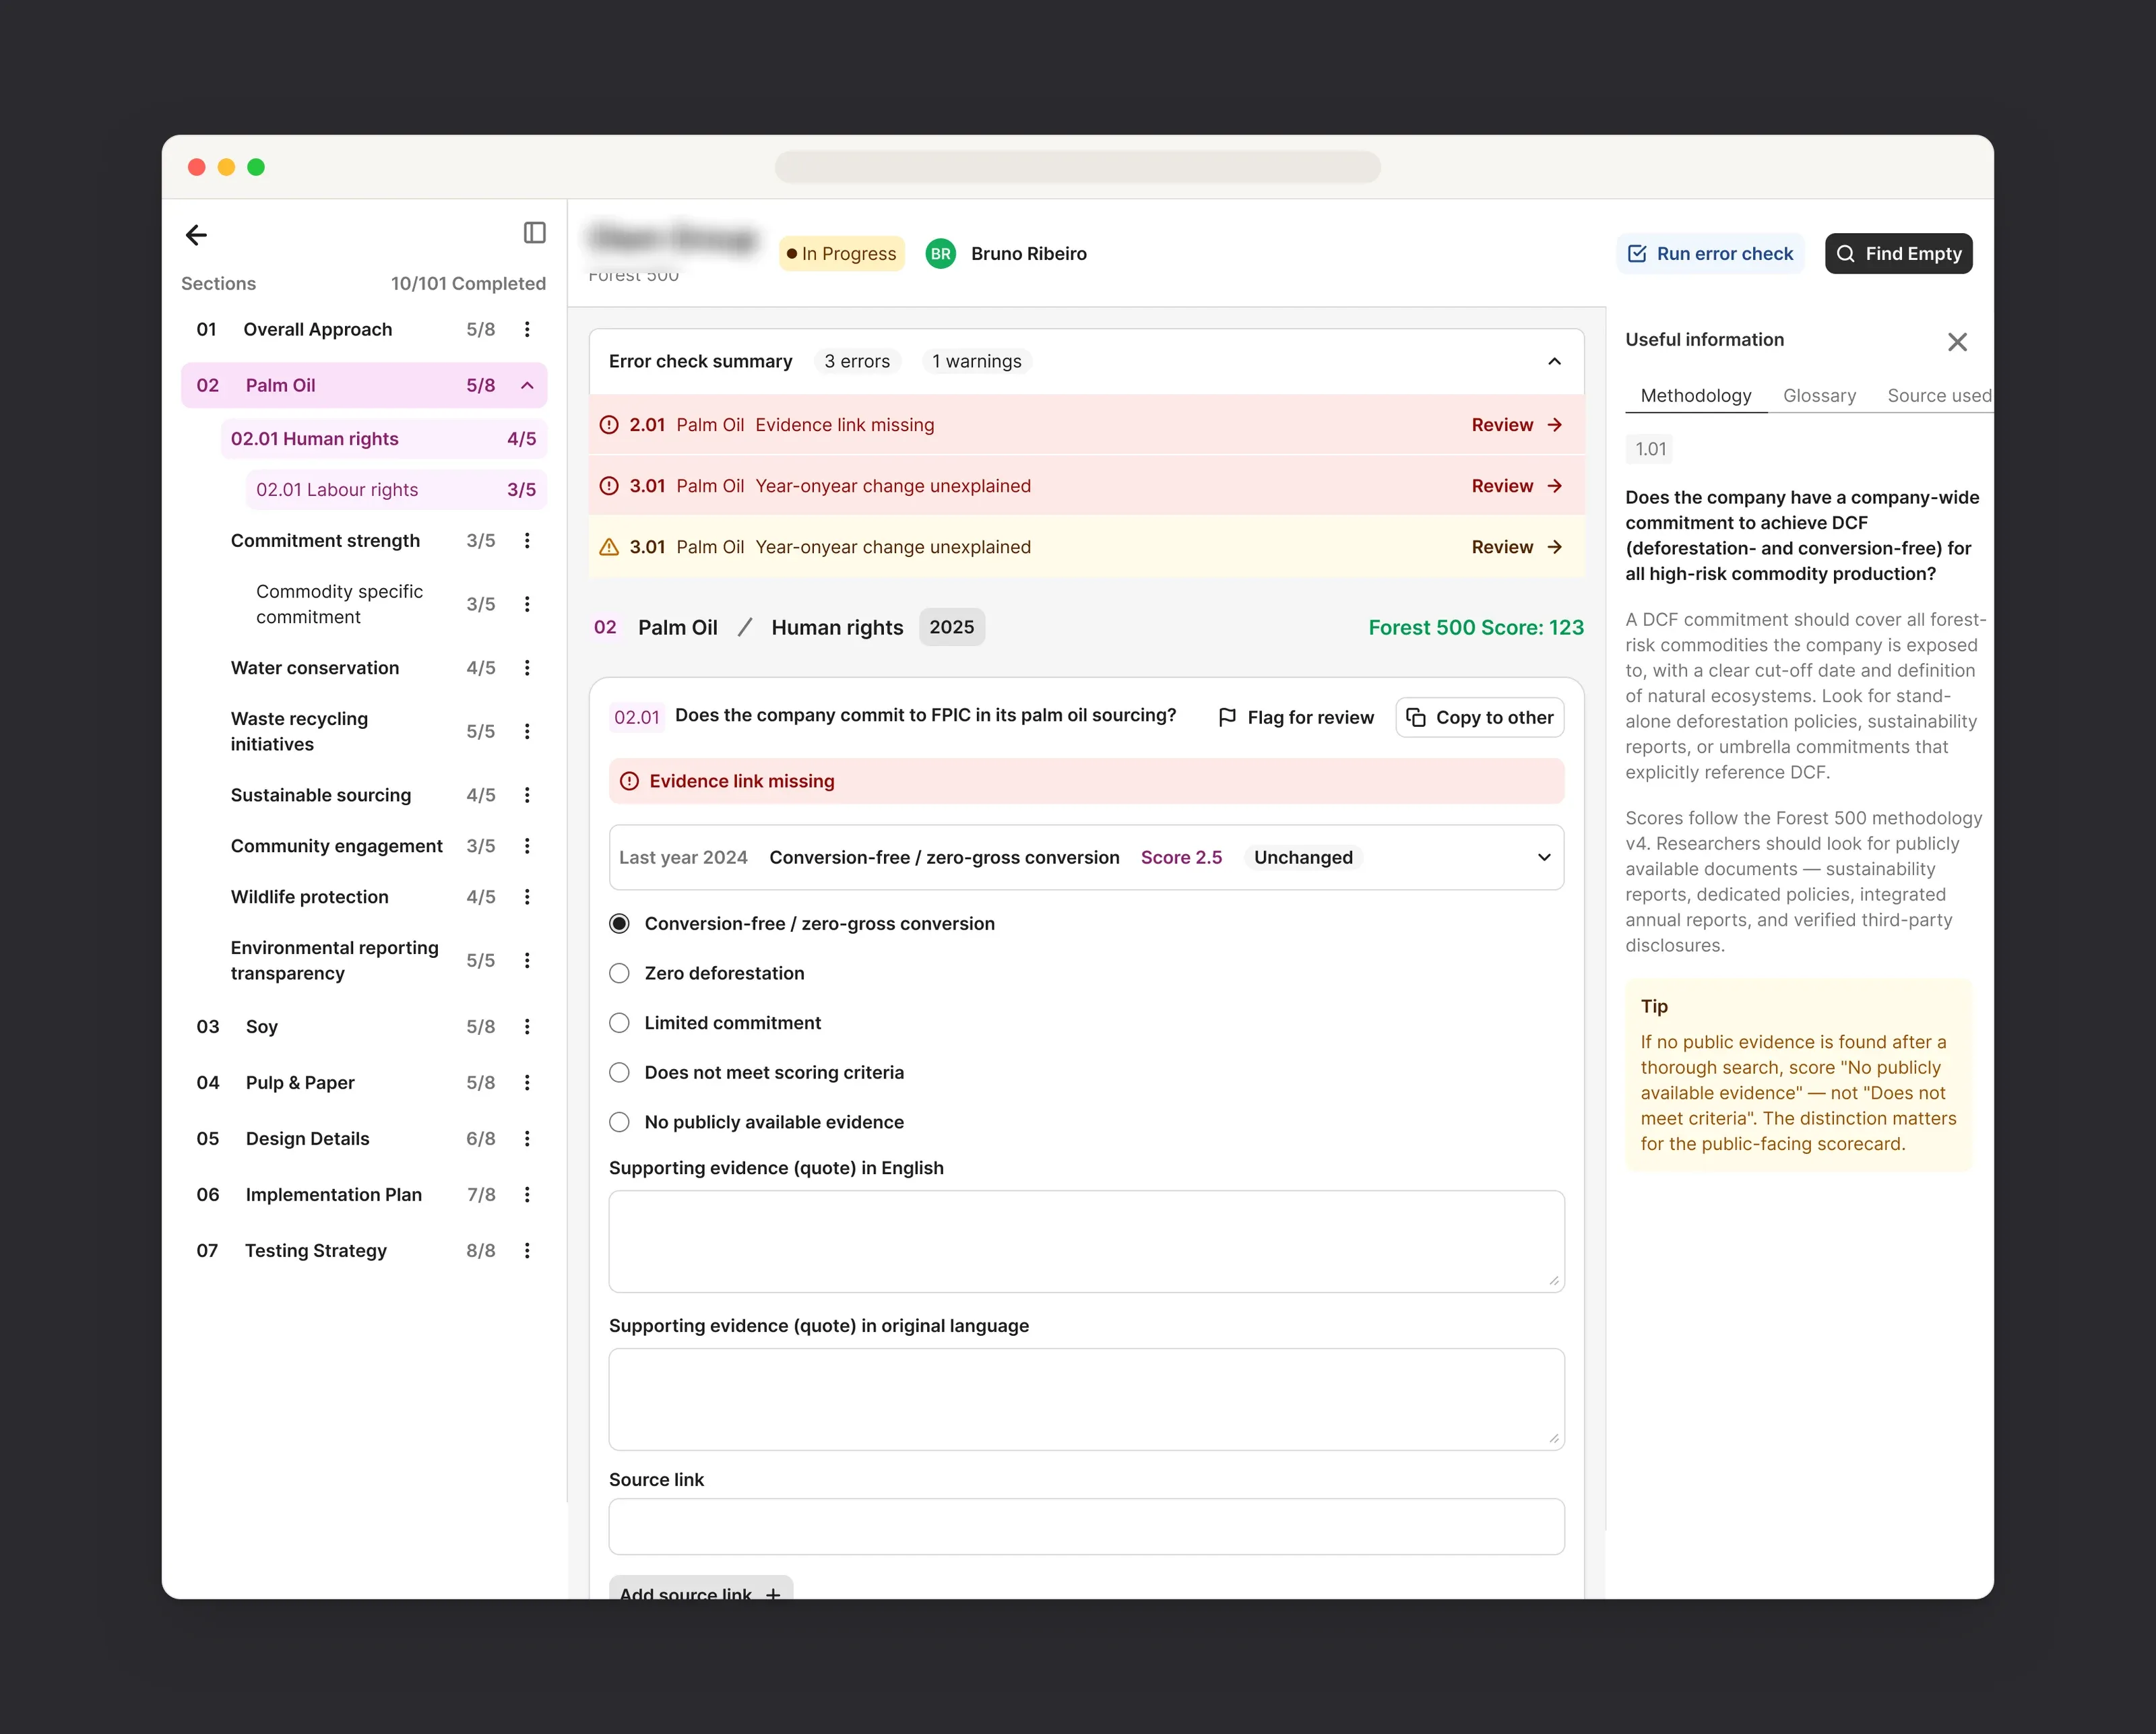
L’éditeur d’évaluation
L’éditeur est organisé en trois colonnes : les sections et leur avancement à gauche, l’indicateur au centre, et le guide méthodologique à droite. La réponse de l’année précédente se trouve juste au-dessus de la nouvelle, et une vérification intégrée liste les preuves manquantes ou les changements inexpliqués, avec un lien direct vers l’indicateur à corriger.
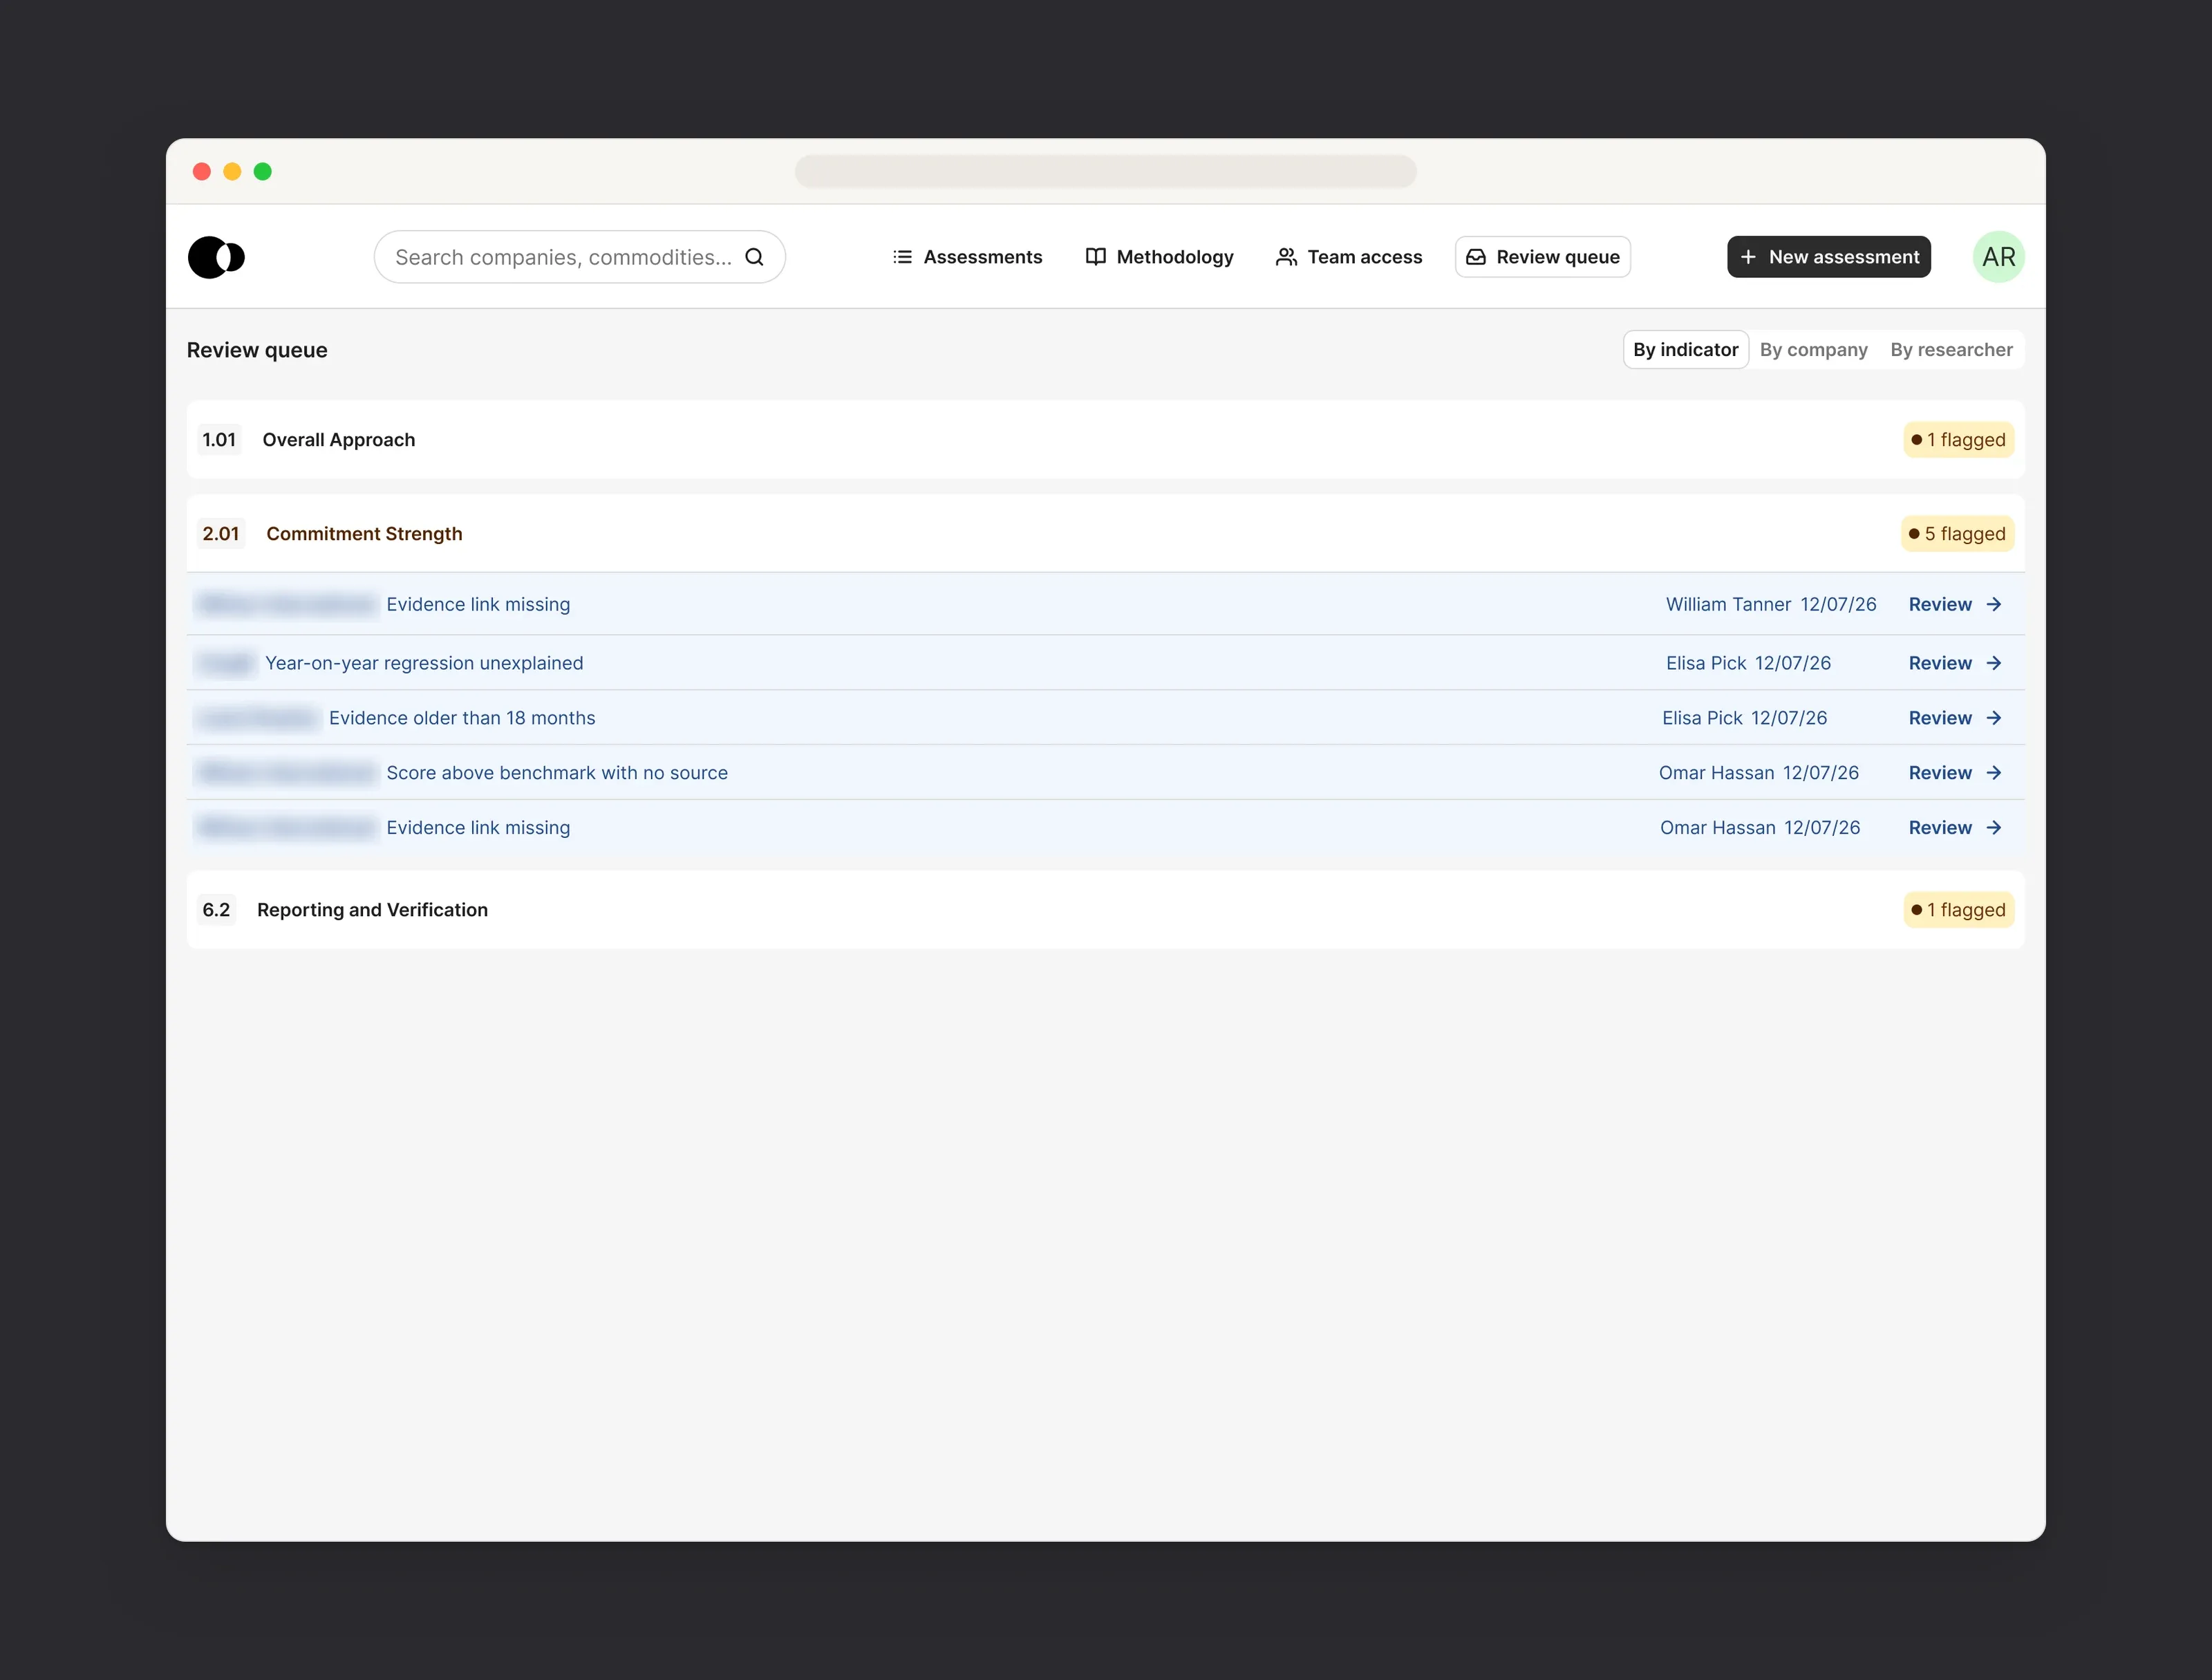
La revue qualité
Les relecteurs disposent d’une file de réponses signalées, regroupées par indicateur, par entreprise ou par chercheur, pour traiter les problèmes similaires ensemble au lieu d’ouvrir les évaluations une par une.
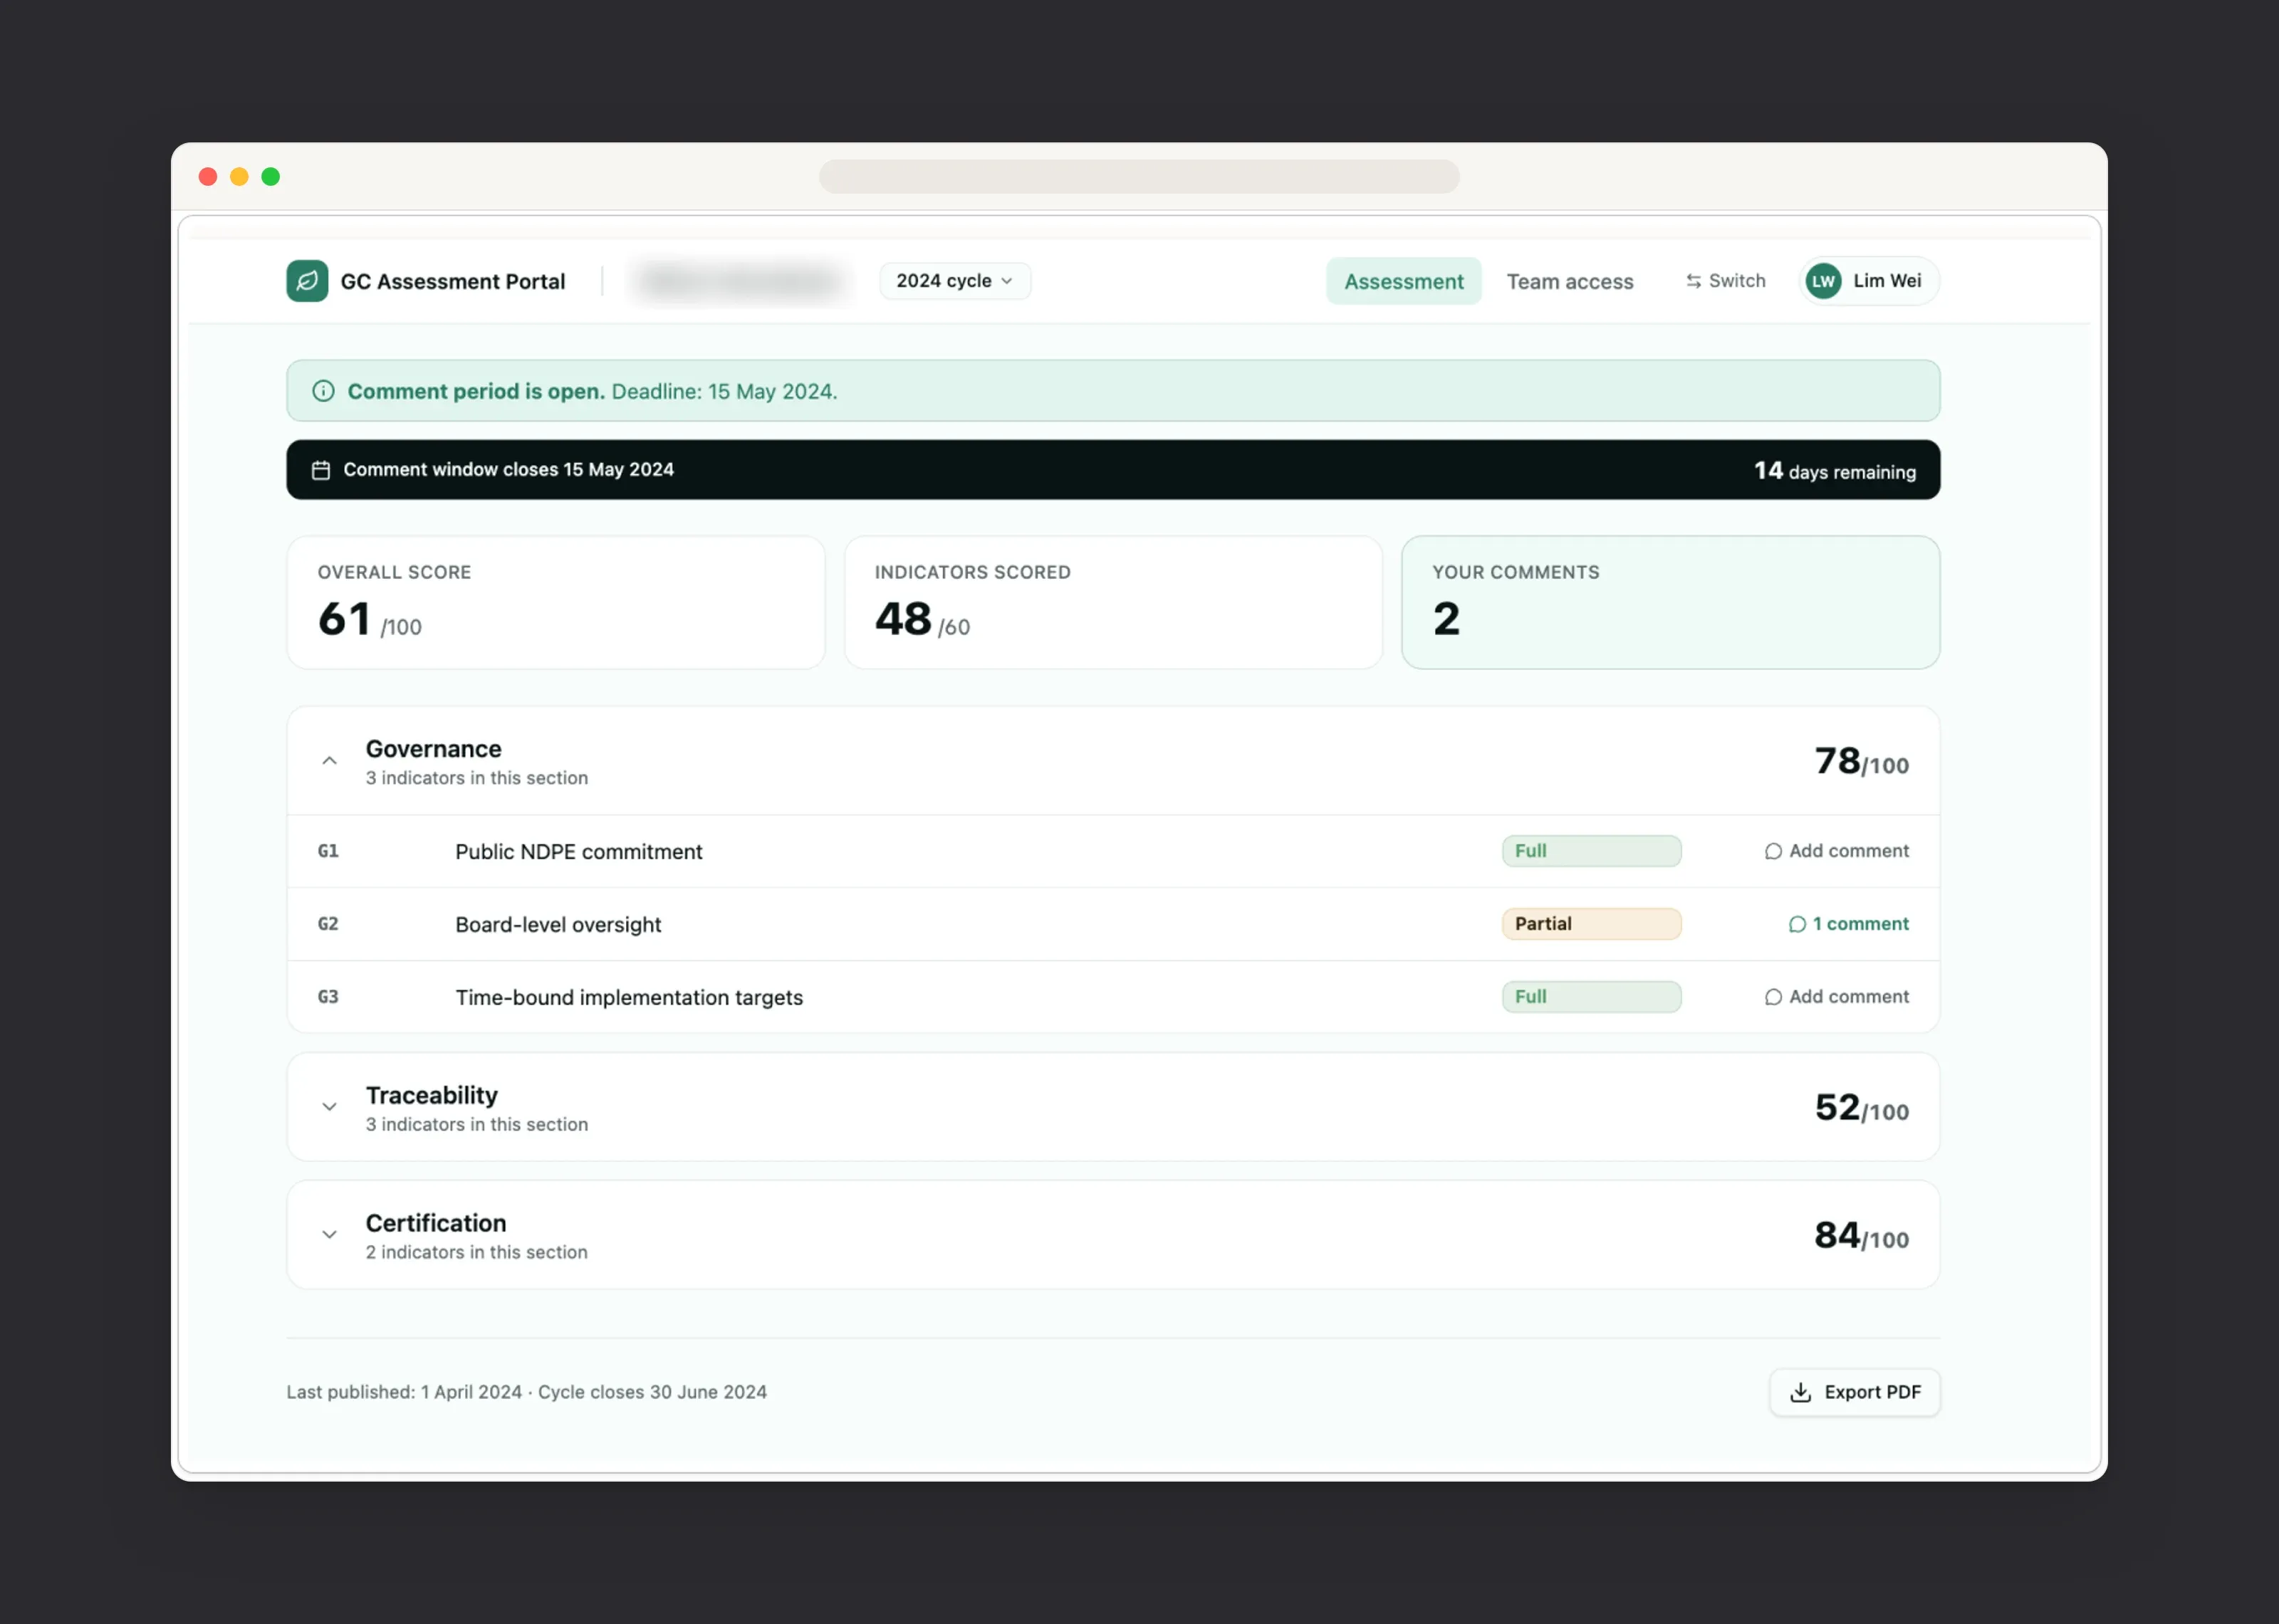
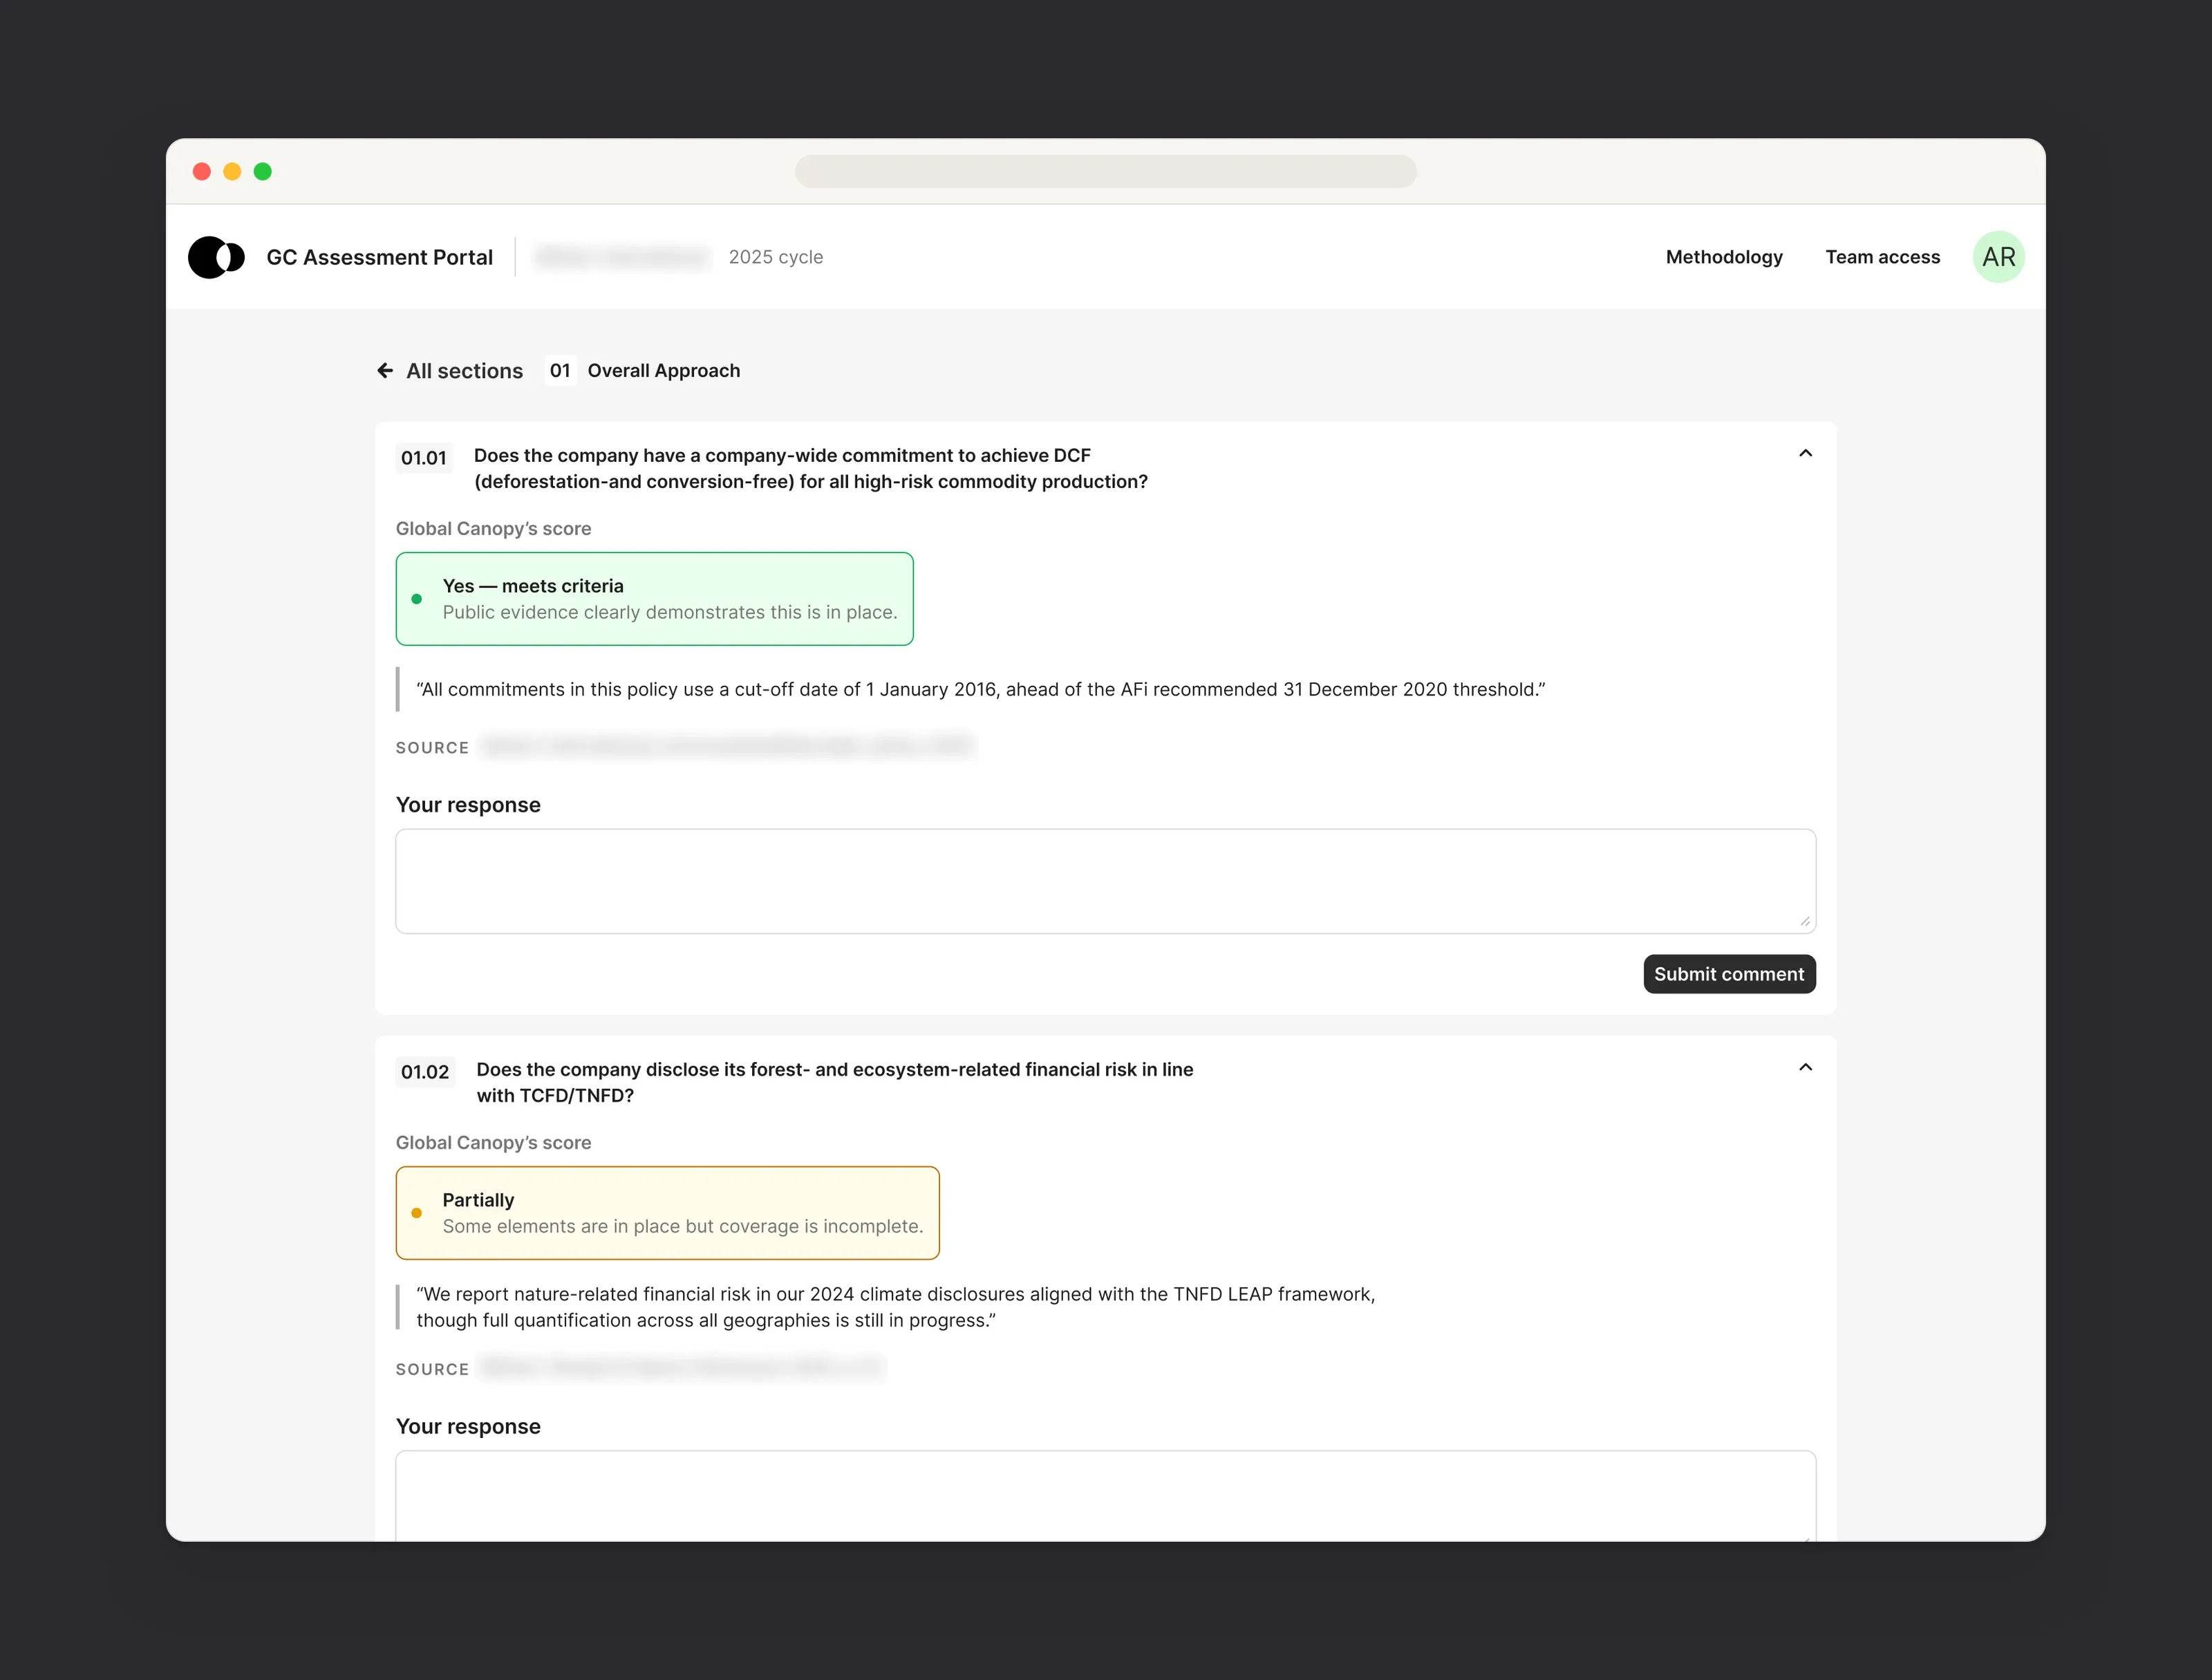
Le portail entreprise
Les entreprises voient chaque indicateur avec le score attribué par Global Canopy, la citation qui le justifie et sa source, et peuvent répondre juste en dessous.
Le contexte à côté de la tâche
La méthodologie, la réponse de l’année précédente et les preuves sont à côté de chaque indicateur, pour que les chercheurs n’aient pas à changer d’outil.
Des erreurs repérées tôt
Des contrôles automatiques signalent les preuves manquantes et les changements inexpliqués avant qu’une évaluation n’arrive en revue.
Pensé pour les équipes
Des responsables et des statuts clairs, et un avertissement quand quelqu’un d’autre modifie la même évaluation.
Juste envers les entreprises
Les entreprises voient le score, la citation et la source derrière chaque réponse, et peuvent répondre en contexte.
Enseignements
Ce que j’ai appris
Cartographier le cycle de vie avant les écrans. S’accorder sur qui fait quoi, et quand, a répondu à la plupart des questions de design avant même que je dessine le premier écran.
Prototyper avec du vrai contenu. Construire sur les vraies données des indicateurs a rendu les retours précis, et a révélé des problèmes que du texte fictif aurait cachés.
Les petites nuances comptent dans un outil de notation. Des détails comme la différence entre « No publicly available evidence » et « Does not meet criteria » changent ce qui apparaît sur un tableau de bord public, alors l’aide doit se trouver exactement là où la décision est prise.